Disponibile anche in inglese: English version.
Le piattaforme di streaming gestiscono decine di milioni di brani. Per organizzarli, raccomandarne di nuovi o leggere le cronologie di ascolto devono raggruppare le canzoni per come suonano. Le etichette di genere non bastano, perché persone diverse etichettano lo stesso brano in modo diverso.
Raggruppare le canzoni per suono è diventato la mia tesi di laurea triennale in Ingegneria Informatica presso l’Università degli Studi di Modena e Reggio Emilia (UNIMORE), Dipartimento di Ingegneria “Enzo Ferrari” (anno accademico 2024/25, relatore Prof. Francesco Guerra, discussa l’8 ottobre 2025): gli algoritmi di clustering non supervisionato riescono a scoprire strutture musicalmente significative a partire dalle sole feature audio? Ho confrontato tre algoritmi di tre famiglie diverse (K-Means, DBSCAN e Spectral Clustering) su due dataset, valutandoli con metriche interne e un’analisi post-hoc dei generi. L’intera pipeline è open source su GitHub(si apre in una nuova scheda).
Perché il clustering, e perché senza etichette
Il clustering raggruppa i dati per similarità senza mai vedere un’etichetta in addestramento. Per la musica conta, perché le etichette di genere sono rumorose, soggettive e incomplete. Un brano è “rock” o “metal”? “Techno” o “trap”? I curatori umani non sono d’accordo, gli artisti mescolano gli stili e molte canzoni sono ibride. Un modello addestrato su queste etichette impara gli stessi disaccordi.
L’approccio non supervisionato parte dai dati. Ogni brano diventa un vettore di misure acustiche, i vettori simili vengono raggruppati e solo dopo si verifica se i gruppi corrispondono ai generi. I generi servono a controllare il risultato, mai ad addestrare. Se emergono cluster che raccolgono, ad esempio, quasi tutta la musica classica senza che al modello sia mai stato detto cosa sia la “classica”, allora le feature catturano davvero qualcosa del suono.
Due dataset, 167 feature per brano
Ho lavorato con due dataset complementari:
- GTZAN, il benchmark standard per la classificazione dei generi musicali, introdotto da Tzanetakis e Cook. Contiene 1000 brani da 30 secondi, 100 per ciascuno di 10 generi: blues, classical, country, disco, hip-hop, jazz, metal, pop, reggae e rock.
- Dataset custom: 684 brani dalle mie playlist Spotify, etichettati con 5 macro-generi volutamente distinti: techno (208), classica (187), rock & metal (157), funk (69), trap (63). Sono le mie playlist, quindi il set è di parte, e la tesi lo dice. Ho scelto etichette che si distinguono bene anche per un ascoltatore distratto, così quando un algoritmo le confonde, l’errore dice qualcosa.
Ogni brano è stato convertito in 167 feature numeriche con librosa(si apre in una nuova scheda): 40 coefficienti MFCC (come l’orecchio umano percepisce il timbro), 72 feature chroma nelle varianti STFT/CQT/CENS (contenuto armonico), descrittori spettrali (centroide, banda, rolloff, contrasto, flatness), feature polinomiali di forma, statistiche di tempo e onset, Tonnetz (atmosfera armonica), zero-crossing rate, energia RMS e rapporti di separazione armonico-percussiva.
Prima di qualsiasi clustering, una pipeline di preprocessing rigorosa in ordine fisso: rimozione dei duplicati, standardizzazione z-score (obbligatoria, perché le distanze euclidee sarebbero dominate dalle feature con scala maggiore) e PCA al 98% della varianza per combattere la curse of dimensionality, per cui in alta dimensione le distanze si concentrano e smettono di discriminare.
Un protocollo sperimentale riproducibile
Tutti gli esperimenti passano da un’unica pipeline Python basata su scikit-learn(si apre in una nuova scheda) Gira solo su CPU e ogni componente casuale riceve un seed fisso, così le esecuzioni sono confrontabili. Per ogni algoritmo ho testato una griglia di iperparametri su entrambi i dataset:
| Algoritmo | Griglia Custom | Griglia GTZAN |
|---|---|---|
| K-Means | ||
| Spectral | , | , |
| DBSCAN | , | , |
Ogni configurazione è stata valutata con due metriche interne che tirano in direzioni opposte:
- Silhouette score (meglio se alto): quanto ogni punto è più vicino al proprio cluster rispetto al cluster vicino più simile.
- Indice di Davies–Bouldin (meglio se basso): la similarità media di ogni cluster con il vicino più simile, bilanciando dispersione interna e distanza tra cluster.
Il modello migliore per algoritmo massimizza la Silhouette, risolve i pareggi con il Davies–Bouldin e deve superare un controllo qualitativo: una proiezione PCA a 2 componenti più un report genere-per-cluster. I generi non entrano mai nell’addestramento. Compaiono solo in questi report a posteriori.
K-Means: la baseline
K-Means partiziona i punti in gruppi minimizzando la varianza interna attorno a centroidi:
Assume cluster compatti e circa sferici e richiede a priori. Ma è veloce, interpretabile (ogni centroide si legge come il “profilo sonoro tipico” del gruppo) e un punto di riferimento obbligato.
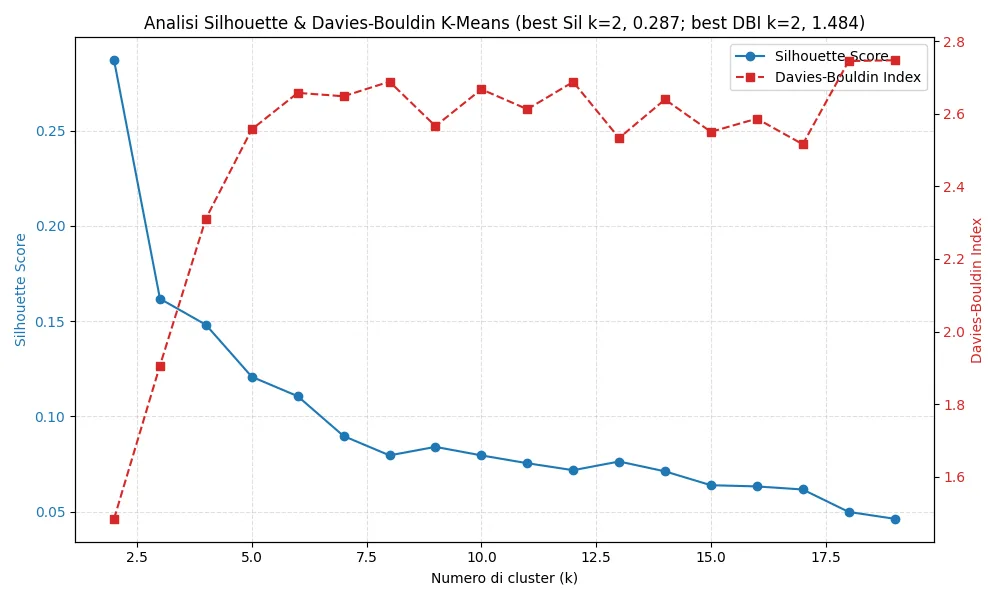
Sul dataset custom con , K-Means ha raggiunto Silhouette 0.121 e Davies–Bouldin 2.558. Il risultato più netto: il 98.4% di tutti i brani classici è finito in un unico cluster (184 punti su 190, purezza 96.8%). Anche techno e trap si separano bene, mentre il funk collassa nel cluster rock & metal, con 56 brani funk accanto a 122 rock & metal, e ha senso: i due generi hanno un timbro molto simile (chitarre distorte, bande di energia simili).
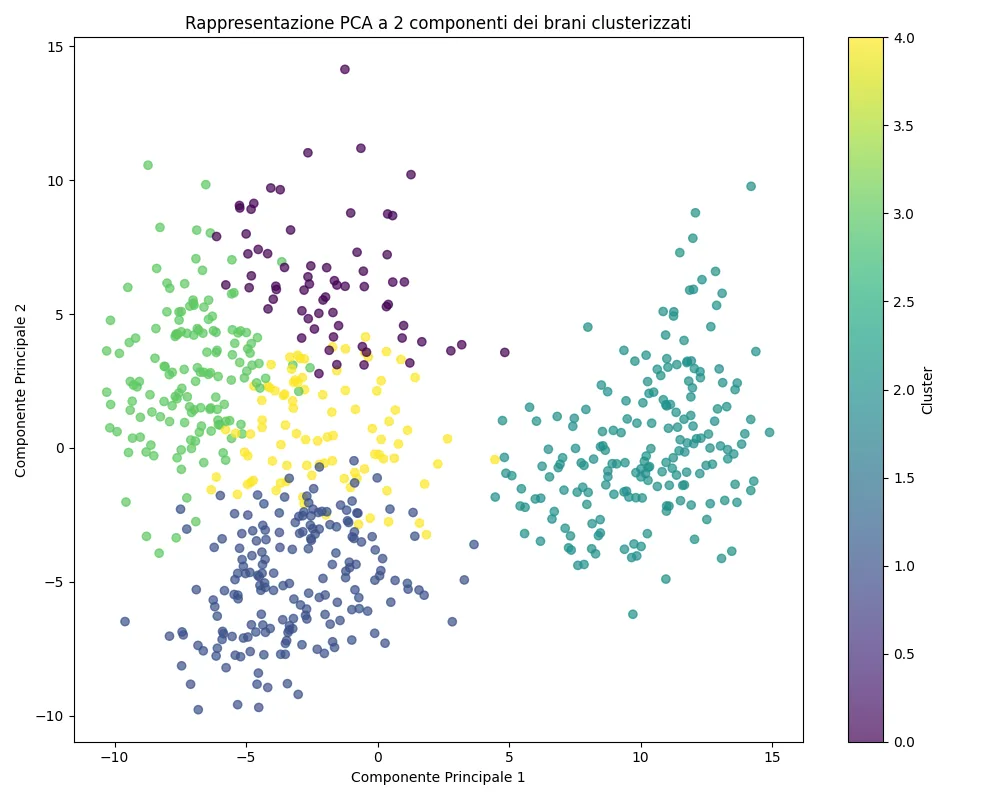
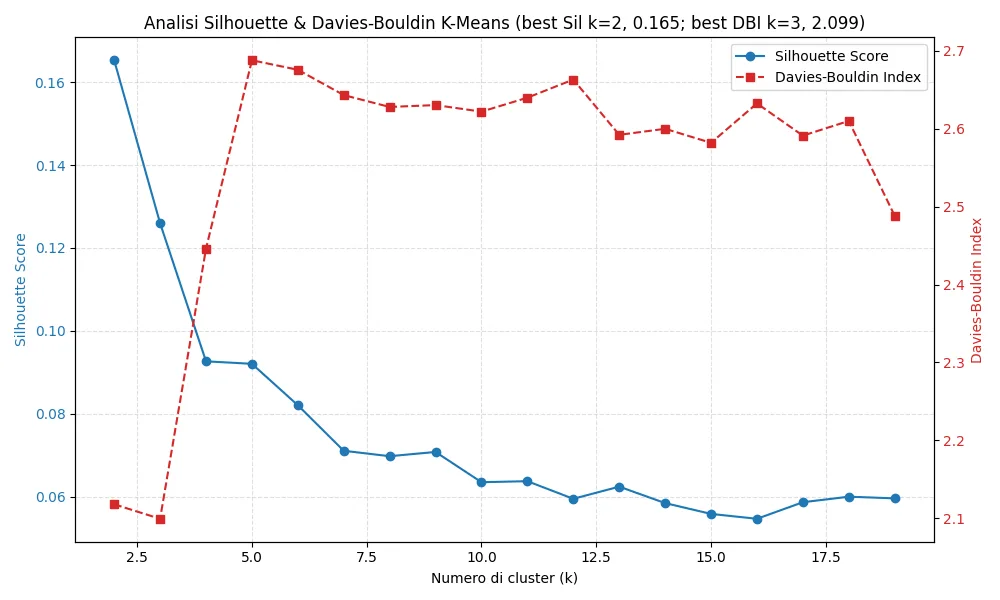
Su GTZAN con i punteggi scendono (Silhouette 0.0635, Davies–Bouldin 2.622), come atteso con dieci generi a grana fine. Eppure l’84.9% dei brani metal resta unito, e ogni cluster è dominato da 1–3 generi imparentati invece che da miscele casuali: reggae con blues, classica con jazz, pop con hip-hop. L’algoritmo non ha recuperato i generi. Ha recuperato famiglie di generi simili, che corrisponde a come suona la musica.
Spectral Clustering: i punteggi migliori
Lo Spectral Clustering costruisce un grafo di similarità sui dati (qui con kernel RBF ), proietta i punti usando i più piccoli autovettori del Laplaciano del grafo ed esegue K-Means in quell’embedding. Cattura separazioni non convesse e curve che sconfiggono i metodi a centroidi, al prezzo di un tuning delicato del grafo e di un costo computazionale maggiore.
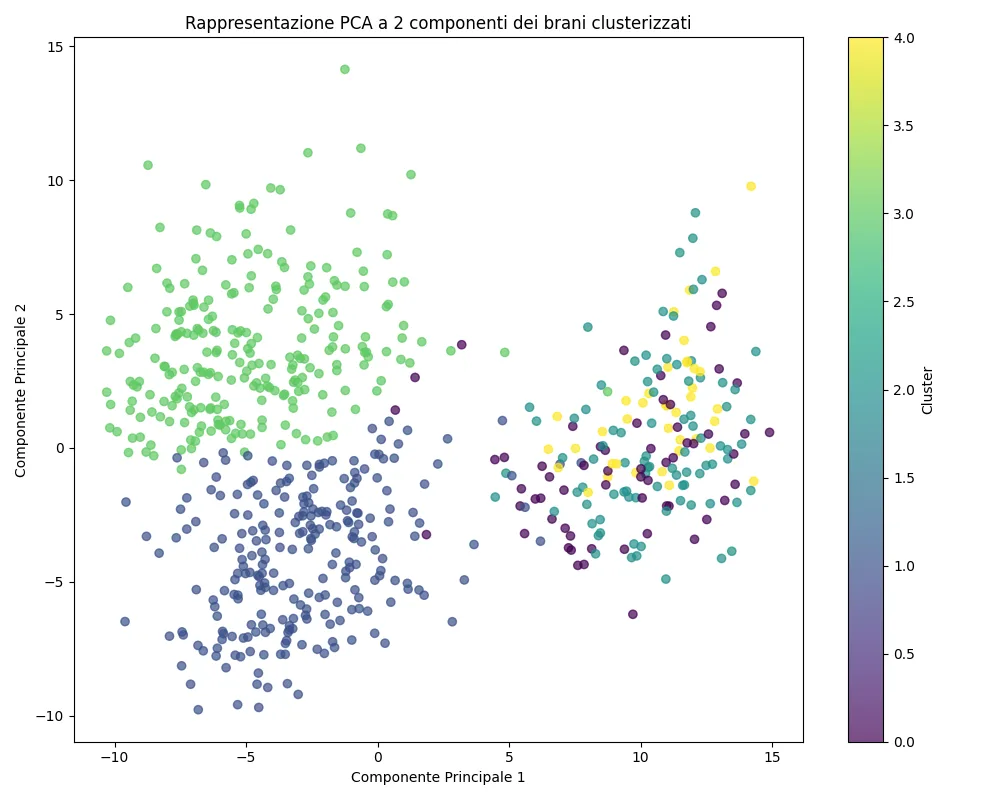
Sul dataset custom (, ) ha ottenuto i migliori punteggi interni di tutto lo studio: Silhouette 0.140, Davies–Bouldin 2.168. Il 95.7% del funk si concentra in un cluster (insieme al rock & metal, di nuovo quella coppia), techno e trap si fondono in un altro, e la classica si separa nettamente da tutto il resto.
Su GTZAN (, ): Silhouette 0.0715, Davies–Bouldin 2.484, con l’87.1% del metal coeso. Non emergono cluster puri a singolo genere, ma i generi affini viaggiano sistematicamente insieme.
DBSCAN: non ha funzionato
DBSCAN trova regioni dense separate da zone sparse, non richiede , tollera forme arbitrarie ed etichetta esplicitamente gli outlier come rumore. Sulla carta sembrava promettente per la musica. In pratica ha fallito su entrambi i dataset: le configurazioni convergono a soli 1–2 cluster etichettando ~41% dei brani come rumore. Sul dataset custom la run “migliore” isola parte della classica e scarica quasi tutto il resto in un unico mega-cluster più il contenitore del rumore.
L’analisi ha trovato tre cause che si sommano:
- Nessuna regione densa separata: anche dopo la PCA, il k-distance plot non mostra un gomito netto, quindi nessun globale è giustificato. Valori piccoli etichettano tutto come rumore, valori grandi fondono tutto in un unico blob.
- Densità variabile: feature acustiche eterogenee significano regioni di genere dense e altre rade; un singolo globale non può servire entrambe.
- Spazio stilistico continuo: i brani ibridi formano ponti tra regioni di genere invece di vuoti, e DBSCAN legge i ponti come rumore.
Le metriche interne calcolate sui soli punti non-rumore sembravano persino buone. Ignorano il 41% dei dati, quindi sono fuorvianti. Un passo successivo naturale sarebbe HDBSCAN, che gestisce la densità variabile in modo gerarchico.
Conclusioni
I valori di Silhouette restano bassi ovunque (da 0.06 a 0.14), perché le canzoni si sovrappongono molto nello spazio delle feature. Il confronto tra algoritmi e il controllo sui generi indicano comunque la stessa direzione:
- Si parte da K-Means. È veloce e stabile, e i suoi cluster sono facili da leggere.
- Lo Spectral Clustering vale il costo in più quando i gruppi non sono separabili linearmente. Ha avuto i punteggi migliori e i raggruppamenti più sensati musicalmente.
- DBSCAN è lo strumento sbagliato per feature audio dense, ad alta dimensionalità e a densità variabile. Riservarlo a dati con isole di densità ben separate.
- I cluster sono famiglie di generi, non generi: nessun metodo ha recuperato dieci contenitori puliti, perché le canzoni stesse non sono dieci contenitori puliti. I brani ibridi si distribuiscono tra i cluster, e questo dice tanto sulle etichette di genere quanto sugli algoritmi.
La tesi elenca i suoi limiti: dataset piccoli, bias personale nel set custom ed etichette di genere qualitative. Entro questi limiti, il clustering non supervisionato ha trovato struttura musicale reale dal solo suono. Classica e metal sono finiti nei propri cluster quasi ogni volta.
La pipeline, le ricerche a griglia e i generatori di report sono open source su GitHub(si apre in una nuova scheda). Grazie al Prof. Francesco Guerra per aver seguito la tesi. Read the English version if you prefer.